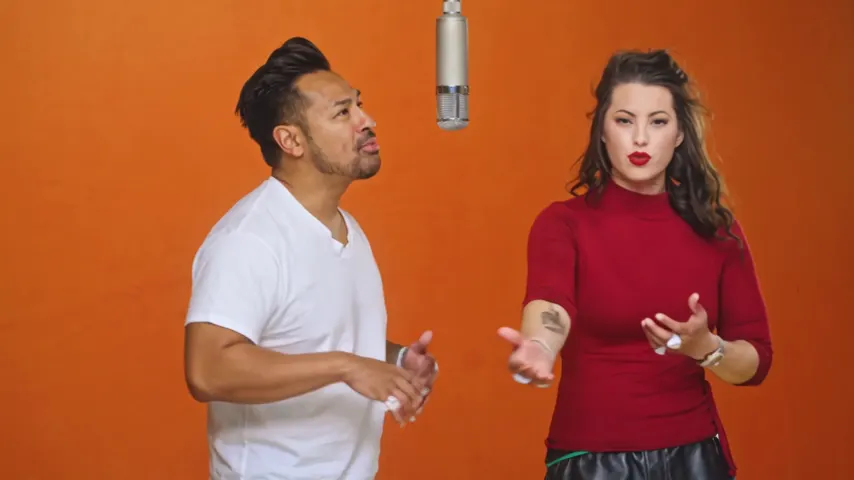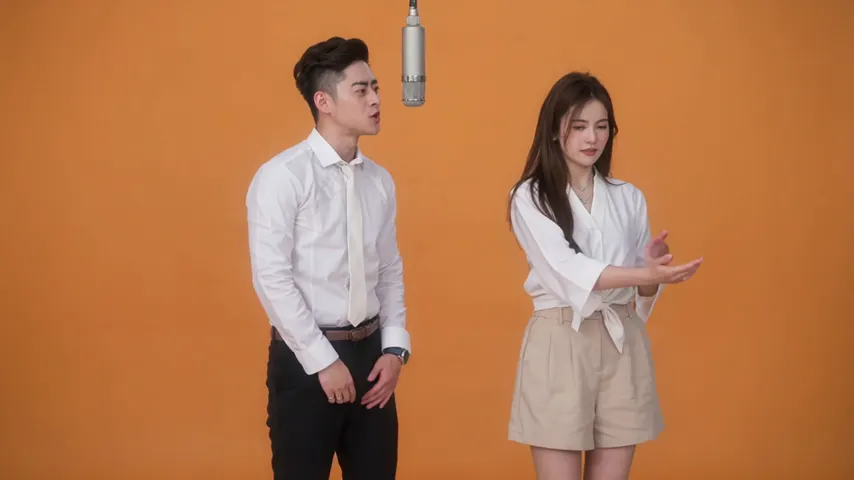
原版音轨,口型对得上
主唱对着吊麦,跟着录音的节奏做出原版主歌的口型。
原曲留在视频里
有些 Hotel Lobby AI 工具只给你一段无声的视频,歌要你自己到 TikTok 里加。这里的视频已经带着原曲:添加两张照片,Wan 3.0 就会把你们俩放进橙色录音棚。左边的人对着《Hotel Lobby》音轨对口型,右边的人助兴。
能,在 Hotel Lobby Video (hotellobbyvideo.net) 上,默认设置就会保留《Hotel Lobby》原曲。添加两张照片,保持默认设置:Wan 3.0 上的「Hotel Lobby 原版」。在橙色录音棚里,左边的人对着原版音轨对口型,右边的人助兴;下载的 MP4 里已经有这首歌,不用再到 TikTok 里加。一条 480p、12 秒的视频 6 积分(最小的积分包是 10 积分 $9.99,不用订阅),通常需要约 5 到 15 分钟。Seedance 模型不保留原曲,而是写一段新的 AI 说唱。
更新于
声音从哪里来
Hotel Lobby AI 工具处理声音有三种做法。有的只给一段无声的视频,让你在 TikTok 里加上 Hotel Lobby 的声音。有的写一首新的 AI 歌,听起来像另一首歌。有的把原版录音留在文件里。这个页面做的是第三种。
Wan 3.0 是这里的默认模型。我们把《Hotel Lobby》原版录音发给它,作为要跟着走的声音,截成和录音棚动作一样的秒数。在我们的测试里,成片里的人声和原版录音非常接近(人声部分的相关系数在 0.90 到 0.97 之间),主唱也跟着它对口型。搭档踩着节拍做反应,就像 Quavo 和 Takeoff 在 COLORS 上的那场表演。
歌从表演的开头开始放:5 秒的视频放前 5 秒,15 秒的视频放前 15 秒。原曲不能选别的段落;想用另一段,或者换一首歌,就把它当作你自己的歌上传。
自己生成音频的视频模型,没法直接沿用一段有名的录音。我们提供的另一类模型 Seedance,会拒绝带着原曲的请求:我们有 6 次付费测试因为音频版权被拦下。用这类模型做的工具,要么发出无声的视频,要么写一段新的 AI 说唱。Wan 3.0 会跟着给它的音轨走,所以能保留原曲。
文件里有这首歌,不代表你获得了它的授权。Hotel Lobby Video 和歌手及其唱片公司没有关联,也不授予这段录音的任何权利。公开发到 TikTok 或 Reels 时,App 里自带的 Hotel Lobby 声音才是有授权的版本:发布时加上它,再把视频自带的声音调低,免得两段声音叠在一起。
三步搞定
每人一张清晰照片,或者一张你们俩的合照。左边的人唱原版主歌,右边的人助兴。
默认设置已经是 Wan 3.0 上的「Hotel Lobby 原版」:录音棚原版动作,配原版音轨。选好时长(5、8、10、12 或 15 秒)和画面比例:发 TikTok 和 Reels 选 9:16。
一条 480p、12 秒的视频 6 积分。下载 MP4:原曲就在里面。
你会得到什么
主唱对着吊麦,跟着录音的节奏做出原版主歌的口型。
不用在 TikTok 里找声音,也不用在 CapCut 里对齐:MP4 一放就带着这首歌。
在「动作」里上传你自己的舞蹈片段,声音保留「Hotel Lobby 音轨」:你们俩会照着你的动作,配着原曲表演。具体看参考视频指南。
可选 480p、720p 或 1080p。默认 480p,清晰度越高,用的积分越多。
| 你的选择 | 模型 | MP4 里放的是什么 |
|---|---|---|
| Hotel Lobby 原版(默认) | Wan 3.0 | 《Hotel Lobby》原曲,从表演的开头开始 |
| 你的歌 | Wan 3.0 | 你上传的音频里的 2 到 15 秒 |
| AI 说唱 | Seedance 模型 | 一段新的主歌和伴奏,不是原曲 |
本站生成
两条使用我们生成流程制作的 Wan 3.0 精选成片。每条双人说唱视频下方都列出设置,并说明是产品测试还是通过网站生成。播放时打开声音,检查完整表演;这些案例不能证明整体成功率。
Wan 3.0 · 480p · 10 秒 · 16:9
Wan 3.0 · 720p · 12 秒 · 16:9
其他创作者的作品
这些视频由其他工具制作,用于展示 Hotel Lobby 形式,不能作为本站生成效果的证据。每条都链接到署名创作者。
这个就能,用默认设置就行:Wan 3.0 上的「Hotel Lobby 原版」。你下载的 MP4 里就有《Hotel Lobby》原曲。
不用,视频本身就带着这首歌。如果你还是想加 TikTok 里的 Hotel Lobby 声音,就把视频自带的声音调低,免得两段声音叠在一起。
不用。声音不影响价格:480p 视频,5、8、10、12 或 15 秒对应 3、4、5、6 或 7 积分。
用原曲时不能:它从表演的开头开始放,放的长度和视频一样。想用别的段落,就把那一段当作你自己的歌上传。
不会。Seedance 模型上的 AI 说唱会写一段新的主歌和伴奏。它跟着《Hotel Lobby》音轨的节奏,但不用它的歌词、旋律和人声。
很像。原版录音会作为要跟着走的音轨发给视频模型。在我们的测试里,成片里的人声和原版的相关系数在 0.90 到 0.97 之间。不会写新的歌词。
没有。每条视频在生成时都用积分支付;最小的积分包是 10 积分 $9.99,生成失败会自动退款。
请标明是 AI 生成的,并且只用本人同意的照片。文件里的歌不是我们授权给你的;公开发布时,用 TikTok 自带的 Hotel Lobby 声音,才是有授权的做法。